はじめに
こんにちは。satyamです。
多くのシステムでは、ファイルアップロード後の変換処理を、定期ジョブやスクリプト、アプリケーションサーバーで実行しています。
そのため、処理開始までに時間がかかったり、処理結果の確認に手間がかかることがあります。
Amazon S3 と AWS Lambda を組み合わせることで、ファイルアップロードをきっかけに変換処理を自動実行できます。
また、Amazon DynamoDB に処理ステータスを記録することで、処理結果をすぐに確認できます。
本記事では、Amazon S3 にアップロードした CSV ファイルを AWS Lambda で PDF 形式に変換し、生成したファイルを S3 に保存します。
あわせて、DynamoDB に処理ステータスを記録し、エラー発生時には CloudWatch Logs で内容を確認します。
構成図
以下は、本記事で構築する構成です。
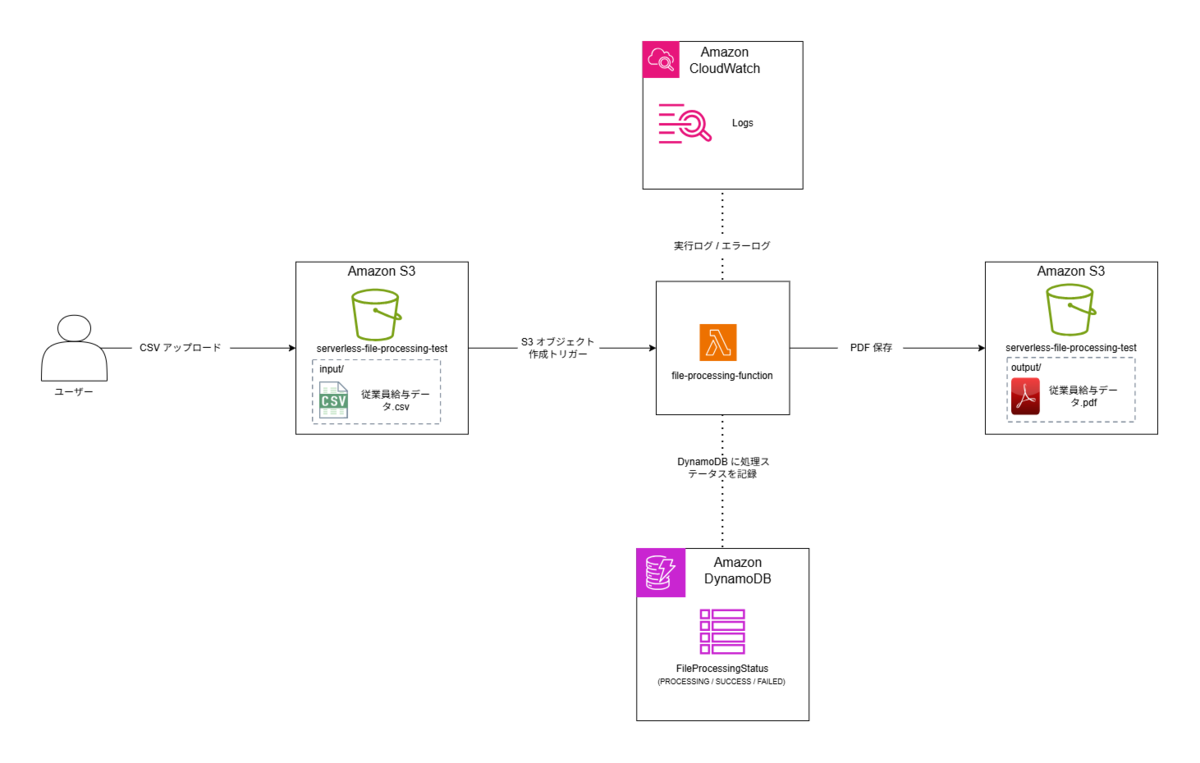
動作フロー
- ユーザーが CSV ファイルを Amazon S3 の
input/にアップロードします。 - S3 のオブジェクト作成イベントをきっかけに、AWS Lambda の
file-processing-functionが実行されます。 - Lambda 関数は処理開始時に、Amazon DynamoDB の
FileProcessingStatusテーブルへPROCESSINGを記録します。 - CSV ファイルを PDF に変換し、生成した PDF を S3 の
output/に保存します。 - 処理が正常に完了した場合は
SUCCESS、エラーが発生した場合はFAILEDとエラーメッセージを DynamoDB に記録します。 - Lambda 関数の実行ログやエラー内容は CloudWatch Logs に記録されます。
S3・DynamoDBの設定
1. S3 バケットを作成する
Amazon S3 コンソールの「バケット」→「バケットを作成」を選択します。
バケット名には、以下を入力します。
serverless-file-processing-test
その他の設定はデフォルトのままとし、設定内容を確認して [バケットを作成] を選択します。
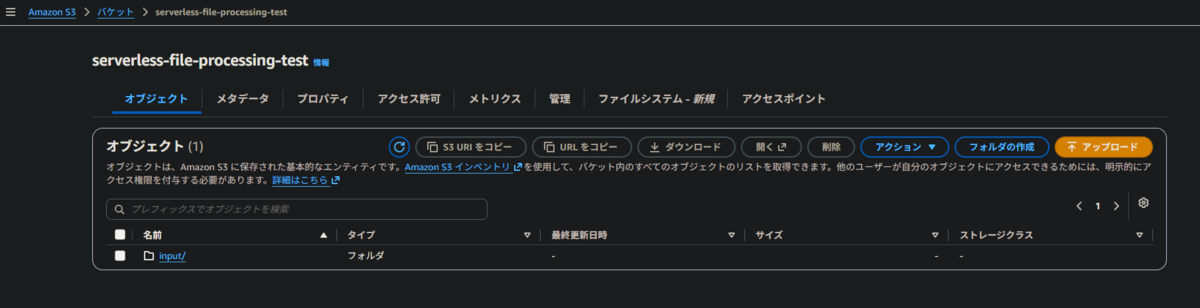
作成したバケットを開き、[フォルダの作成] を選択します。
フォルダ名には、以下を入力します。
input
その他の設定はデフォルトのままとし、設定内容を確認して [フォルダの作成] を選択します。
2. DynamoDB テーブルを作成する
DynamoDB では、各ファイルの処理状況を確認できます。
SUCCESS や FAILED を確認することで、
出力ファイルやログを探さなくても処理結果をすぐに把握できます。
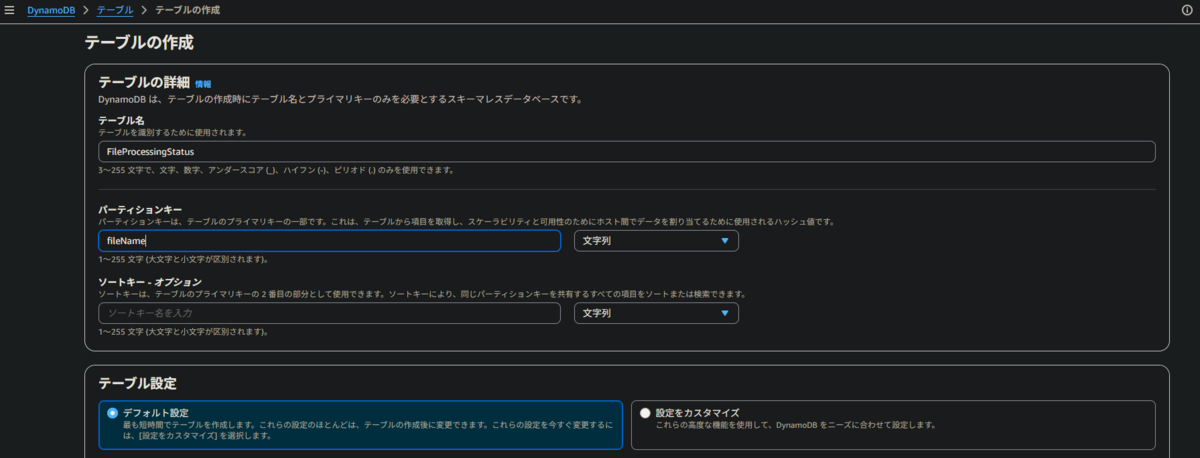
Amazon DynamoDB コンソールの「テーブル」→「テーブルの作成」を選択します。
以下の値を入力します。
テーブル名:FileProcessingStatus
パーティションキー:fileName
データ型:文字列
ソートキーは設定しません。
その他の設定はデフォルトのままとし、設定内容を確認して [テーブルの作成] を選択します。
テーブルの状態が「アクティブ」になれば、DynamoDB テーブルの作成は完了です。
Lambdaの設定
1. Lambda 関数を作成する
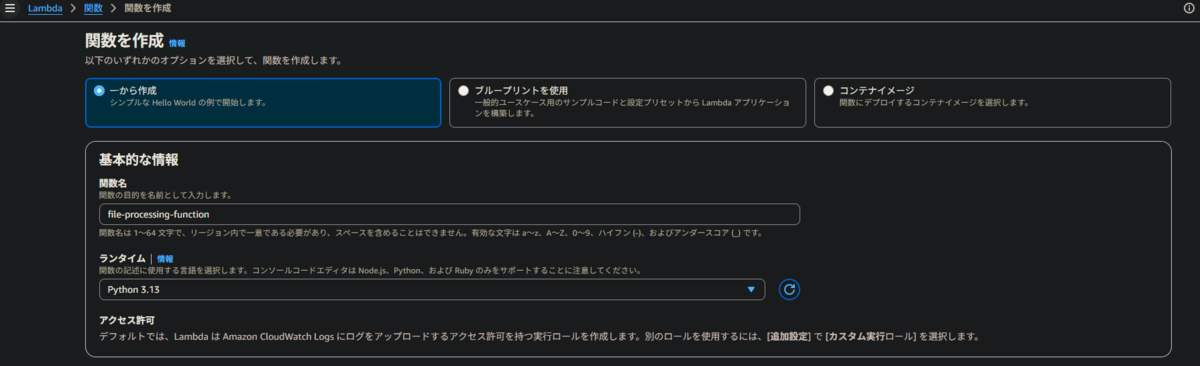
AWS Lambda コンソールの「関数」→「関数の作成」を選択します。
「一から作成」を選択し、以下の値を入力します。
関数名:file-processing-function
ランタイム:Python 3.13
その他の設定はデフォルトのままとし、設定内容を確認して [関数の作成] を選択します。
関数の作成後、「コード」タブを開きます。
「コードソース」にある lambda_function.py を選択し、デフォルトのコードを以下のコードに置き換えます。
import boto3
import csv
import io
import logging
import os
from datetime import datetime, timezone
from urllib.parse import unquote_plus

from reportlab.lib import colors
from reportlab.lib.pagesizes import A4, landscape
from reportlab.lib.units import mm
from reportlab.pdfbase import pdfmetrics
from reportlab.pdfbase.cidfonts import UnicodeCIDFont
from reportlab.platypus import SimpleDocTemplate, Table, TableStyle

logger = logging.getLogger()
logger.setLevel(logging.INFO)

s3 = boto3.client("s3")
dynamodb = boto3.resource("dynamodb")

TABLE_NAME = os.environ["TABLE_NAME"]
OUTPUT_PREFIX = os.environ["OUTPUT_PREFIX"]

table = dynamodb.Table(TABLE_NAME)

pdfmetrics.registerFont(UnicodeCIDFont("HeiseiKakuGo-W5"))


# S3 イベントを受け取り、アップロードされたファイルを処理する
def lambda_handler(event, context):
    for record in event.get("Records", []):
        process_file(record)


# CSV を読み込み、PDF への変換と処理結果の記録を行う
def process_file(record):
    bucket = record["s3"]["bucket"]["name"]
    key = unquote_plus(record["s3"]["object"]["key"])
    file_name = os.path.basename(key)

    logger.info("Processing started: %s", key)

    save_status(file_name, "PROCESSING")

    try:
        if not file_name.lower().endswith(".csv"):
            raise ValueError(
                "対応していないファイル形式です。CSVファイルをアップロードしてください。"
            )

        response = s3.get_object(Bucket=bucket, Key=key)
        content = response["Body"].read().decode("utf-8-sig")

        rows = list(csv.reader(io.StringIO(content)))

        if len(rows) < 2:
            raise ValueError("CSVファイルにデータがありません。")

        output_name = f"{os.path.splitext(file_name)[0]}.pdf"
        output_key = f"{OUTPUT_PREFIX}{output_name}"
        pdf_path = f"/tmp/{output_name}"

        create_pdf(rows, pdf_path)

        with open(pdf_path, "rb") as pdf:
            s3.put_object(
                Bucket=bucket,
                Key=output_key,
                Body=pdf,
                ContentType="application/pdf"
            )

        save_status(
            file_name,
            "SUCCESS",
            output_path=output_key
        )

        logger.info(
            "Processing completed: %s -> %s",
            key,
            output_key
        )

    except Exception as error:
        save_status(
            file_name,
            "FAILED",
            error_message=str(error)
        )

        logger.exception("Processing failed: %s", key)
        raise

    finally:
        if "pdf_path" in locals() and os.path.exists(pdf_path):
            os.remove(pdf_path)


# CSV の内容から PDF テーブルを生成する
def create_pdf(rows, pdf_path):
    document = SimpleDocTemplate(
        pdf_path,
        pagesize=landscape(A4),
        leftMargin=12 * mm,
        rightMargin=12 * mm,
        topMargin=15 * mm,
        bottomMargin=15 * mm
    )

    csv_table = Table(rows, repeatRows=1)

    csv_table.setStyle(
        TableStyle([
            ("FONTNAME", (0, 0), (-1, -1), "HeiseiKakuGo-W5"),
            ("BACKGROUND", (0, 0), (-1, 0), colors.lightgrey),
            ("GRID", (0, 0), (-1, -1), 0.5, colors.grey),
            ("ALIGN", (0, 0), (-1, -1), "CENTER"),
            ("VALIGN", (0, 0), (-1, -1), "MIDDLE"),
            ("TOPPADDING", (0, 0), (-1, -1), 6),
            ("BOTTOMPADDING", (0, 0), (-1, -1), 6)
        ])
    )

    document.build([csv_table])


# 処理ステータスを DynamoDB に記録する
def save_status(file_name, status, output_path=None, error_message=None):
    item = {
        "fileName": file_name,
        "status": status,
        "timestamp": datetime.now(timezone.utc).isoformat()
    }

    if output_path:
        item["outputPath"] = output_path

    if error_message:
        item["errorMessage"] = error_message

    table.put_item(Item=item)
コードを入力したら、[Deploy] を選択します。
2. Lambda 実行ロールの権限を設定する
作成した Lambda 関数の「設定」→「アクセス権限」から、ロール名を選択します。
IAM コンソールが開いたら、Lambda 関数用に作成されたポリシーを開きます。
[+] をクリックして [編集] を選択します。
既存の CloudWatch Logs の権限はそのままに、 S3 と DynamoDB の権限を追加します。
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Effect": "Allow",
      "Action": "s3:GetObject",
      "Resource": "arn:aws:s3:::serverless-file-processing-test/input/*"
    },
    {
      "Effect": "Allow",
      "Action": "s3:PutObject",
      "Resource": "arn:aws:s3:::serverless-file-processing-test/output/*"
    },
    {
      "Effect": "Allow",
      "Action": [
        "dynamodb:PutItem"
      ],
      "Resource": "arn:aws:dynamodb:ap-northeast-1:<AWS_ACCOUNT_ID>:table/FileProcessingStatus"
    }
  ]
}
<AWS_ACCOUNT_ID> は、使用する AWS アカウント ID に置き換えてください。
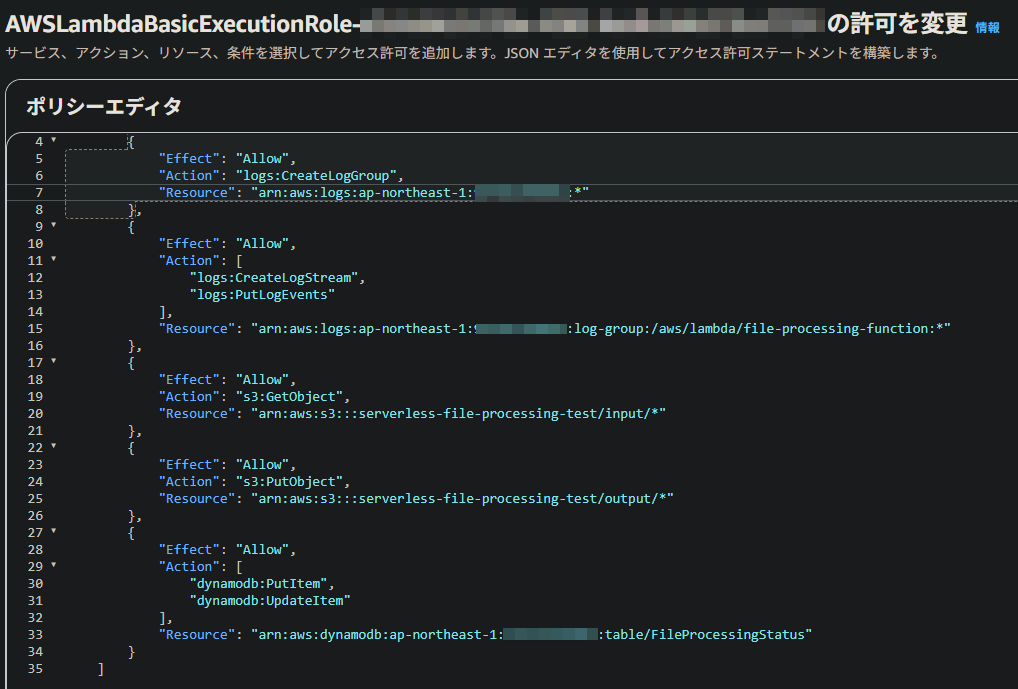
内容を確認して [次へ] を選択し、変更内容を確認したうえで [変更を保存] を選択します。
3. S3 トリガーを設定する
Lambda 関数の「関数の概要」から [トリガーを追加] を選択します。
トリガーに「S3」を選択し、以下の値を設定します。
バケット:serverless-file-processing-test
イベントタイプ:すべてのオブジェクト作成イベント
プレフィックス:input/
「再帰呼び出し」の確認項目にチェックを入れます。
本検証では、input/ をトリガー対象とし、
変換後の PDF は output/ に保存することで再帰呼び出しを防ぎます。
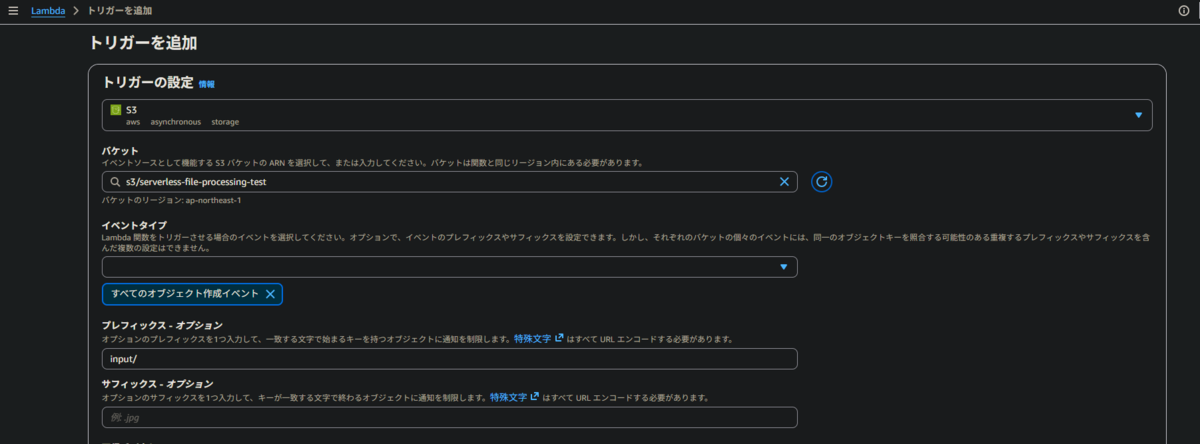
設定内容を確認して [追加] を選択します。
4. 環境変数を設定する
作成した Lambda 関数の「設定」→「環境変数」を開き、[編集] を選択します。
以下の環境変数を追加します。
| キー | 値 |
|---|---|
| TABLE_NAME | FileProcessingStatus |
| OUTPUT_PREFIX | output/ |
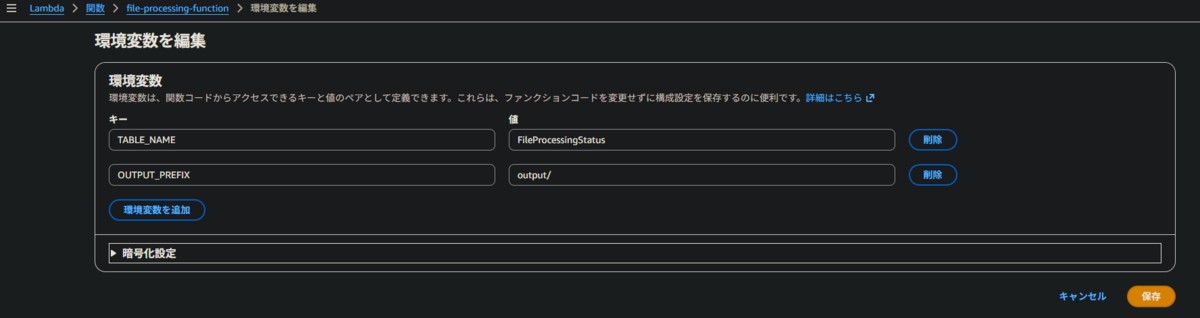
設定内容を確認して [保存] を選択します。
ReportLab Layerの設定
1. AWS CloudShell で ReportLab パッケージを準備する
AWS CloudShell を開き、以下のコマンドを実行します。
mkdir -p reportlab-layer/python
pip3 install reportlab -t reportlab-layer/python
cd reportlab-layer
zip -r reportlab-layer.zip python
ZIP ファイルを作成したら、
CloudShell → 「アクション」 → 「ファイルのダウンロード」を選択します。
「個別のファイルパス」には、以下を入力します。
reportlab-layer/reportlab-layer.zip
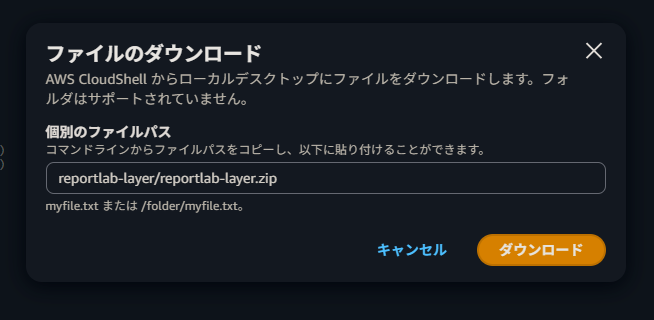
入力内容を確認して 「ダウンロード」を選択し、ZIP ファイルをローカルに保存します。
2. Lambda レイヤーを作成する
AWS Lambda コンソールの「レイヤー」→「レイヤーを作成」を選択します。
「レイヤー設定」の「名前」に、以下を入力します。
reportlab-layer
「ソースコード」では、「.zip ファイルから作成」を選択します。
[ファイルを選択] を選択します。
手順 1 で CloudShell からダウンロードした reportlab-layer.zip をアップロードします。
続いて、以下の値を設定します。
互換性のあるアーキテクチャ:x86_64
互換性のあるランタイム:Python 3.13
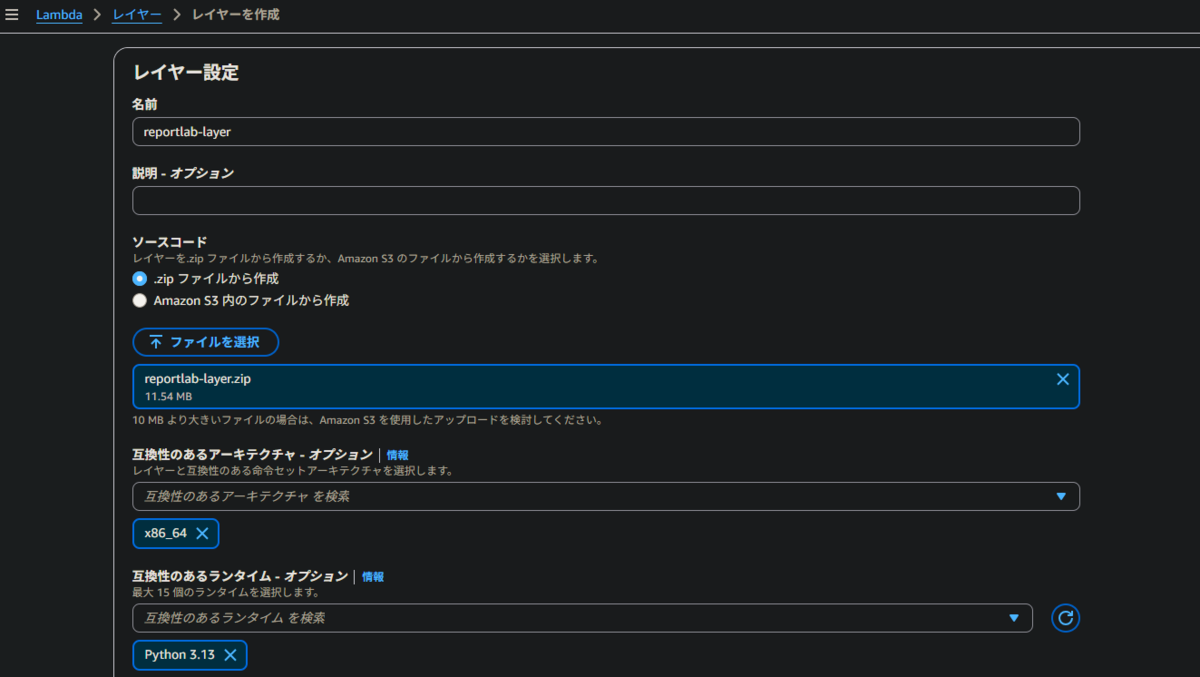
その他の設定はデフォルトのままとし、設定内容を確認して [作成] を選択します。
3. Lambda 関数にレイヤーを追加する
AWS Lambda コンソールの「関数」→「file-processing-function」を開き、
「コード」タブを選択します。
「レイヤー」セクションの [編集] を選択します。
「レイヤーの追加」を選択し、「カスタムレイヤー」を選択します。
以下の値を設定します。
カスタムレイヤー:reportlab-layer
バージョン:1
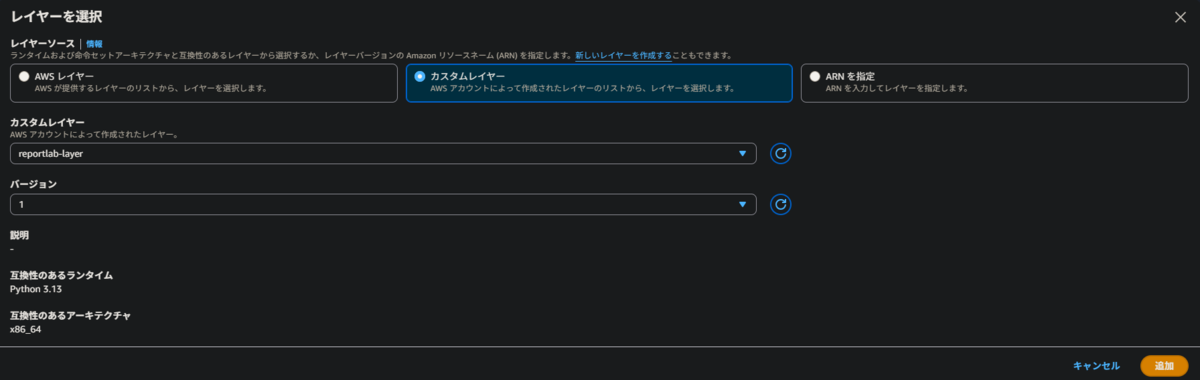
設定内容を確認して [追加] を選択します。
レイヤーの編集画面に戻ったら、[保存] を選択します。
レイヤーの追加が完了すると、
Lambda 関数から ReportLab を利用した PDF 生成が可能になります。
動作確認
1. サンプル CSV を準備する
本検証では、従業員の給与データを記載したサンプル CSV ファイルを使用します。
ファイル名には、以下を使用します。
従業員給与データ.csv
CSV ファイルの内容例は以下のとおりです。
社員ID,氏名,部署,対象月,基本給,残業代,通勤手当,控除額,差引支給額
E001,社員A,営業部,2026年8月,"¥320,000","¥28,500","¥15,000","¥58,200","¥305,300"
E002,社員B,開発部,2026年8月,"¥380,000","¥42,000","¥12,000","¥71,500","¥362,500"
E003,社員C,総務部,2026年8月,"¥295,000","¥12,500","¥10,000","¥52,300","¥265,200"
E004,社員D,開発部,2026年8月,"¥410,000","¥36,800","¥18,000","¥79,400","¥385,400"
E005,社員E,情報システム部,2026年8月,"¥310,000","¥15,200","¥11,500","¥55,800","¥280,900"
2. CSV ファイルを S3 にアップロードする
Amazon S3 コンソールの「バケット」を開き、
「serverless-file-processing-test」→「input/」を選択します。
[アップロード] を選択します。
アップロード画面で [ファイルを追加] を選択し、以下のファイルを選択します。
従業員給与データ.csv
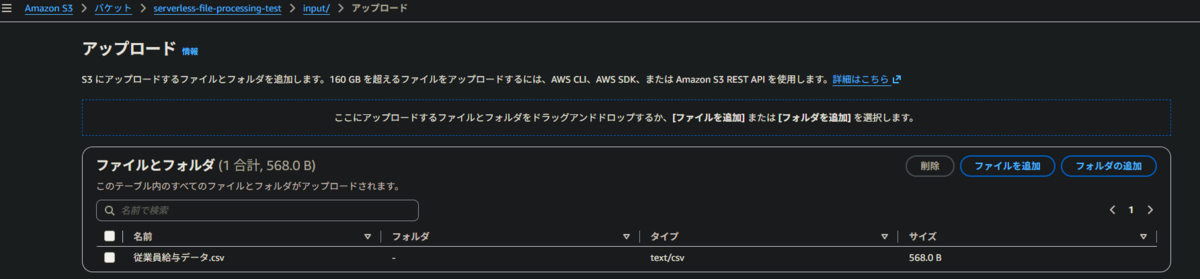
ファイルを選択したら、[アップロード] を選択します。
アップロードを実行し、「input/」配下にファイルが保存されていることを確認します。
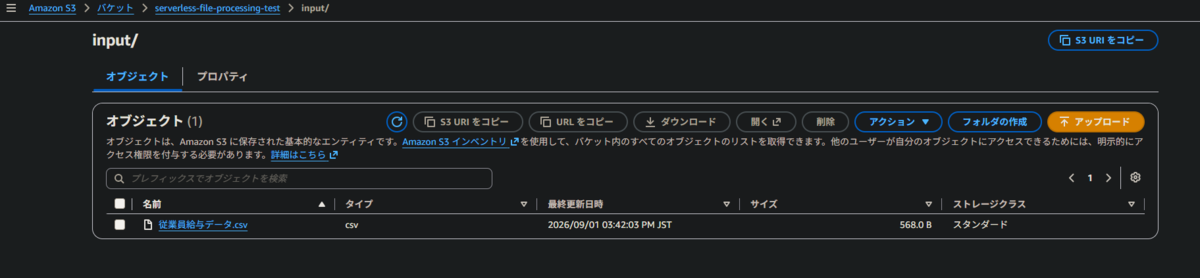
CSV ファイルをアップロードすると、Lambda 関数が自動で実行されます。
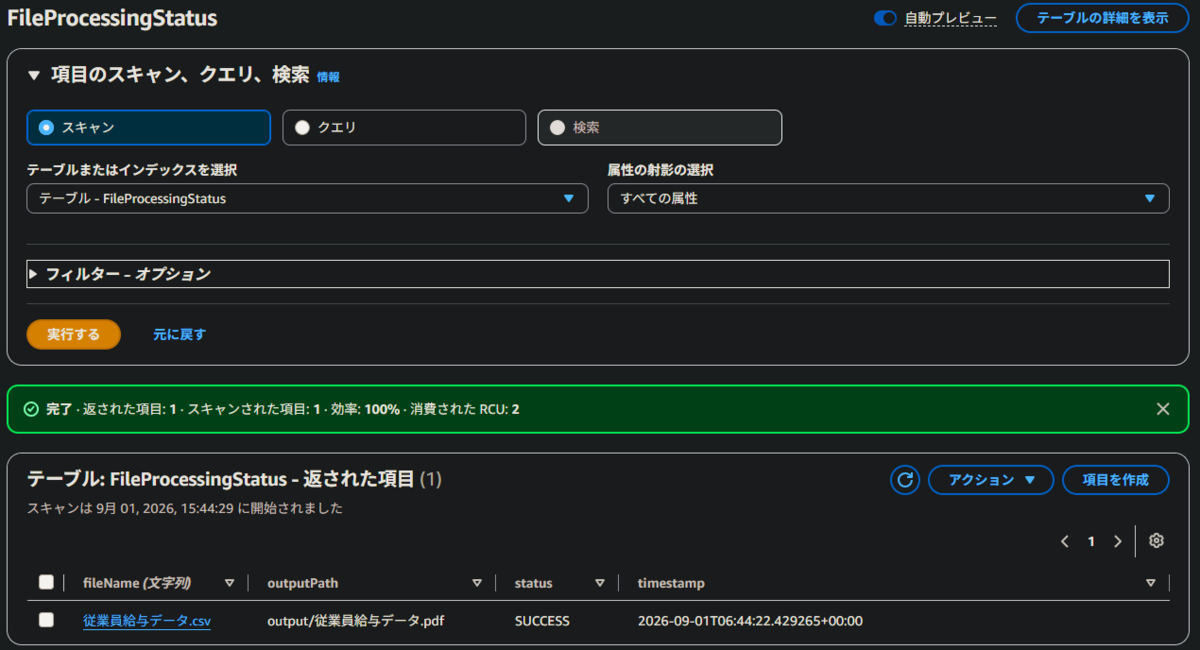
3. DynamoDB で処理結果を確認する
Amazon DynamoDB コンソールの「テーブル」→「FileProcessingStatus」を開きます。
画面右上の [テーブルアイテムの探索] を選択します。
「テーブル: FileProcessingStatus - 返された項目」に、
アップロードした CSV ファイルの項目が作成されていることを確認します。
以下の内容が記録されていることを確認します。
fileName:従業員給与データ.csv
outputPath:output/従業員給与データ.pdf
status:SUCCESS
timestamp:<実行日時>
status が SUCCESS になっていることで、
CSV ファイルの変換処理が正常に完了したことを確認できます。
4. 生成された PDF ファイルを確認する
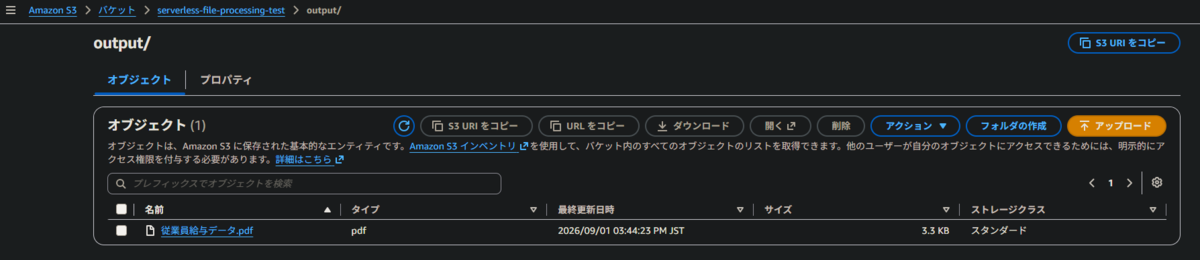
Amazon S3 コンソールの「バケット」→
「serverless-file-processing-test」→「output/」を開きます。
以下のファイルが生成されていることを確認します。
従業員給与データ.pdf
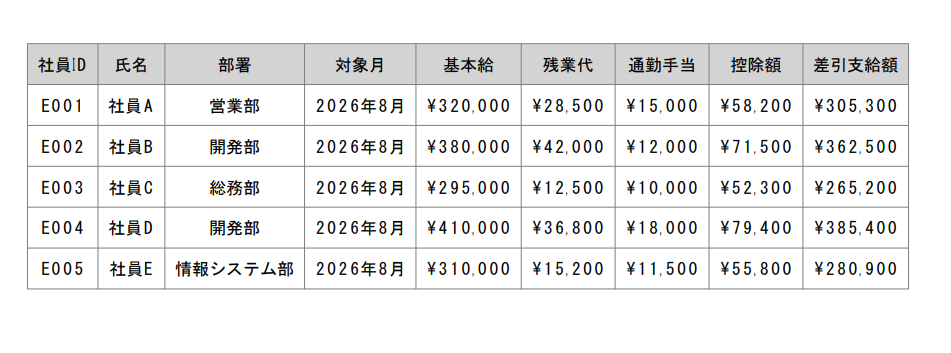
PDF ファイルをダウンロードし、
CSV ファイルの給与データが PDF レポートとして正しく表示されていることを確認します。
5. エラー時の動作を確認する
次に、CSV 以外のファイルをアップロードした場合の動作を確認します。
以下のテストファイルを準備します。
Error-Test-File.txt
ファイルの内容は任意で問題ありません。
例:
このファイルは、対応していない形式の動作確認用です。
Amazon S3 コンソールの「バケット」→
「serverless-file-processing-test」→「input/」を開きます。
[アップロード] → [ファイルを追加] を選択し、
以下のファイルをアップロードします。
Error-Test-File.txt
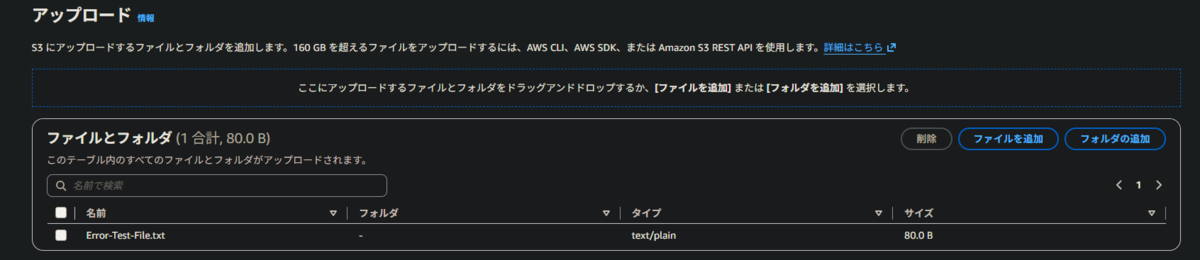
ファイルを選択したら、[アップロード] を選択します。
ファイルをアップロードすると、Lambda 関数が自動で実行されます。
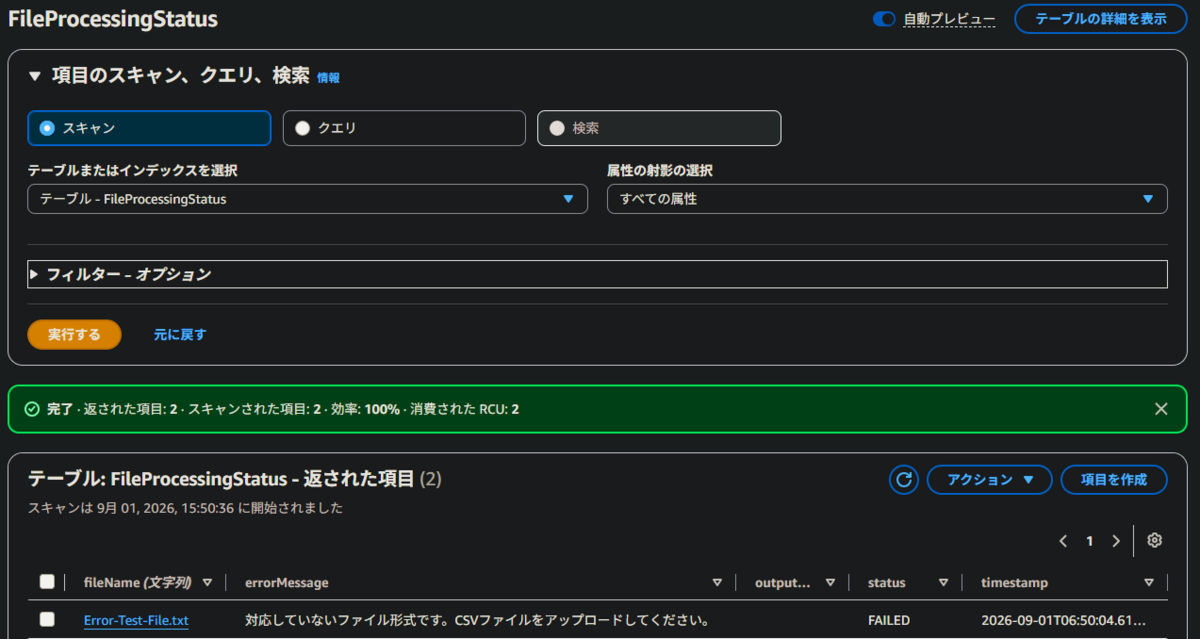
次に、Amazon DynamoDB コンソールの「テーブル」→「FileProcessingStatus」を開きます。
[テーブルアイテムの探索] を選択します。
以下の内容が記録されていることを確認します。
fileName:Error-Test-File.txt
errorMessage:対応していないファイル形式です。CSVファイルをアップロードしてください。
status:FAILED
timestamp:<実行日時>
status が FAILED になっていることで、
対応していないファイル形式がエラーとして処理されたことを確認できます。
Amazon S3 コンソールの「バケット」→
「serverless-file-processing-test」→「output/」を開きます。
Error-Test-File.txt に対応する PDF ファイルが生成されていないことを確認します。
6. CloudWatch Logs でエラー内容を確認する
Lambda 関数の実行ログは CloudWatch Logs に自動で記録されるため、
本検証では追加のログ設定は不要です。
AWS Lambda コンソールの「関数」→「file-processing-function」を開きます。
「モニタリング」から [CloudWatch ログを表示] を選択します。
Error-Test-File.txt をアップロードした時間帯の「ログストリーム」を開きます。
以下の内容を確認します。
Processing started: input/Error-Test-File.txt
続いて、以下のエラーが記録されていることを確認します。
[ERROR] ValueError: 対応していないファイル形式です。CSVファイルをアップロードしてください。
あわせて、スタックトレースからエラーが発生した箇所を確認します。
File "/var/task/lambda_function.py", line 47, in process_file
    raise ValueError(...)
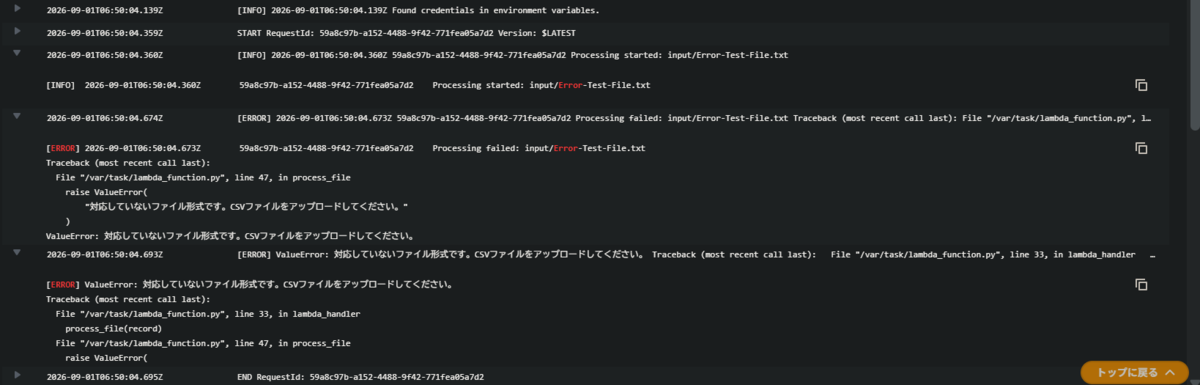
今回の例では、CSV 形式ではない Error-Test-File.txt がアップロードされたため、
Lambda 関数でエラーとして処理されています。
CloudWatch Logs は、エラー発生時のトラブルシューティングに使用します。
エラーメッセージやスタックトレースから、
失敗の原因やエラーが発生した箇所を確認できます。
まとめ
本記事では、Amazon S3、AWS Lambda、Amazon DynamoDB、CloudWatch Logs を使用して、サーバーレスなファイル変換処理を構成しました。
S3 にファイルをアップロードすると Lambda が自動で実行され、
CSV ファイルを PDF に変換して S3 に保存し、処理結果を DynamoDB に記録する流れを確認しました。
また、処理に失敗した場合は、DynamoDB で FAILED を確認し、
CloudWatch Logs からエラー内容を確認できることも検証しました。
今回の構成は、CSV から PDF への変換に限らず、
さまざまなイベント駆動型のファイル処理に応用できます。
